
2024년 6월 WING 세션에서 발표한 내용을 글로 옮기면서, 발표에서는 시간상 다루지 못한 설계와 구현의 세부를 보탰습니다.
배경
2024년 초, "AI가 주니어 애널리스트의 일을 대체할 것"이라는 기사가 연달아 나왔습니다. 신입이 하던 리서치 보조 업무, 즉 데이터를 모아 정해진 형식의 보고서로 정리하는 일을 AI가 몇 초 만에 끝낸다는 이야기였습니다. 그 일을 직접 만들어 보면 "어디까지 되는지"와 "어디서부터 안 되는지"를 둘 다 알 수 있겠다고 생각했습니다. 마침 한국투자증권이 개인 개발자에게 Open API를 열어 두고 있었습니다.
무엇을 만들었나
하려는 일은 세 가지였습니다.
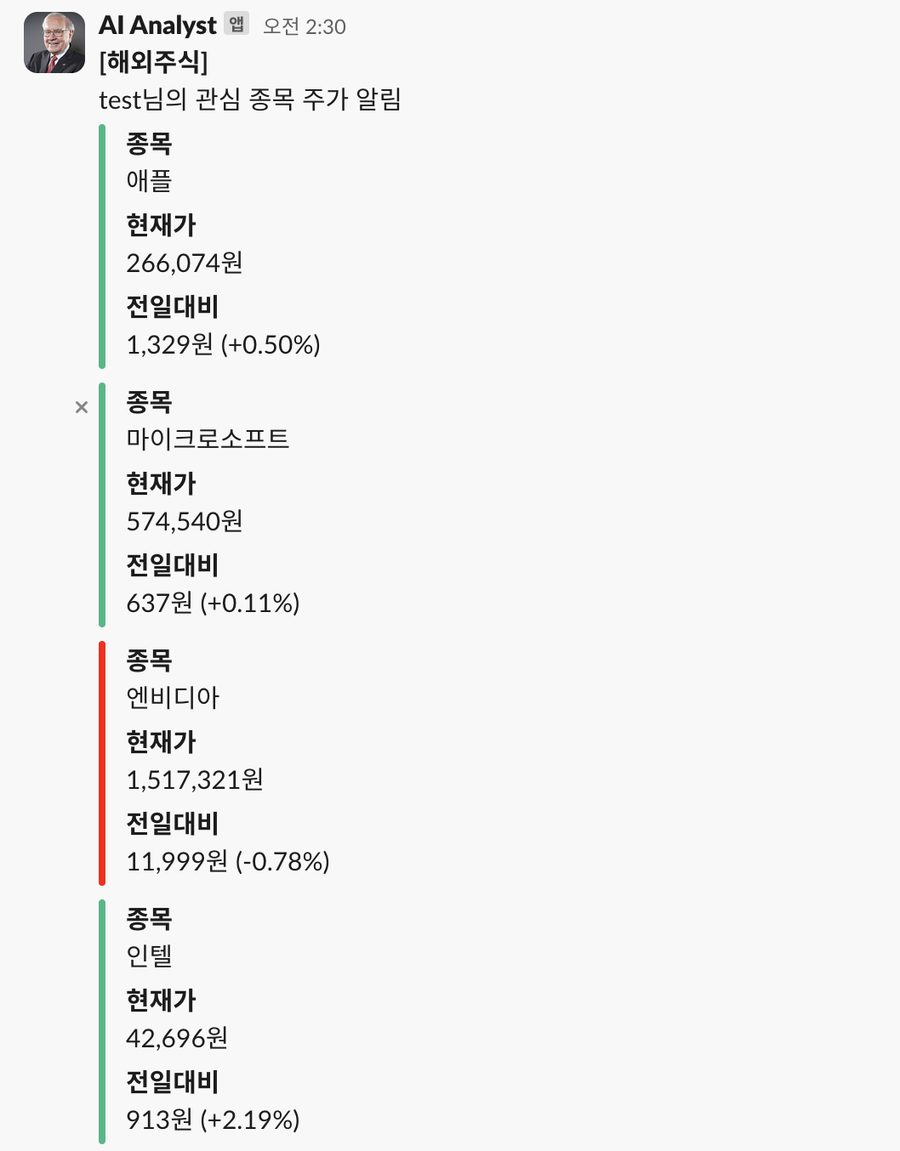
- 실시간 주가 알림. 관심 종목의 시세를 받아 Slack으로 보낸다.
- 포트폴리오 비중 리포트. 관심 종목 전체에 대해 비중을 제안하는 리포트를 만든다.
- 종목 리서치 리포트. 종목 하나를 재무 지표 기준으로 분석한 리포트를 만든다.
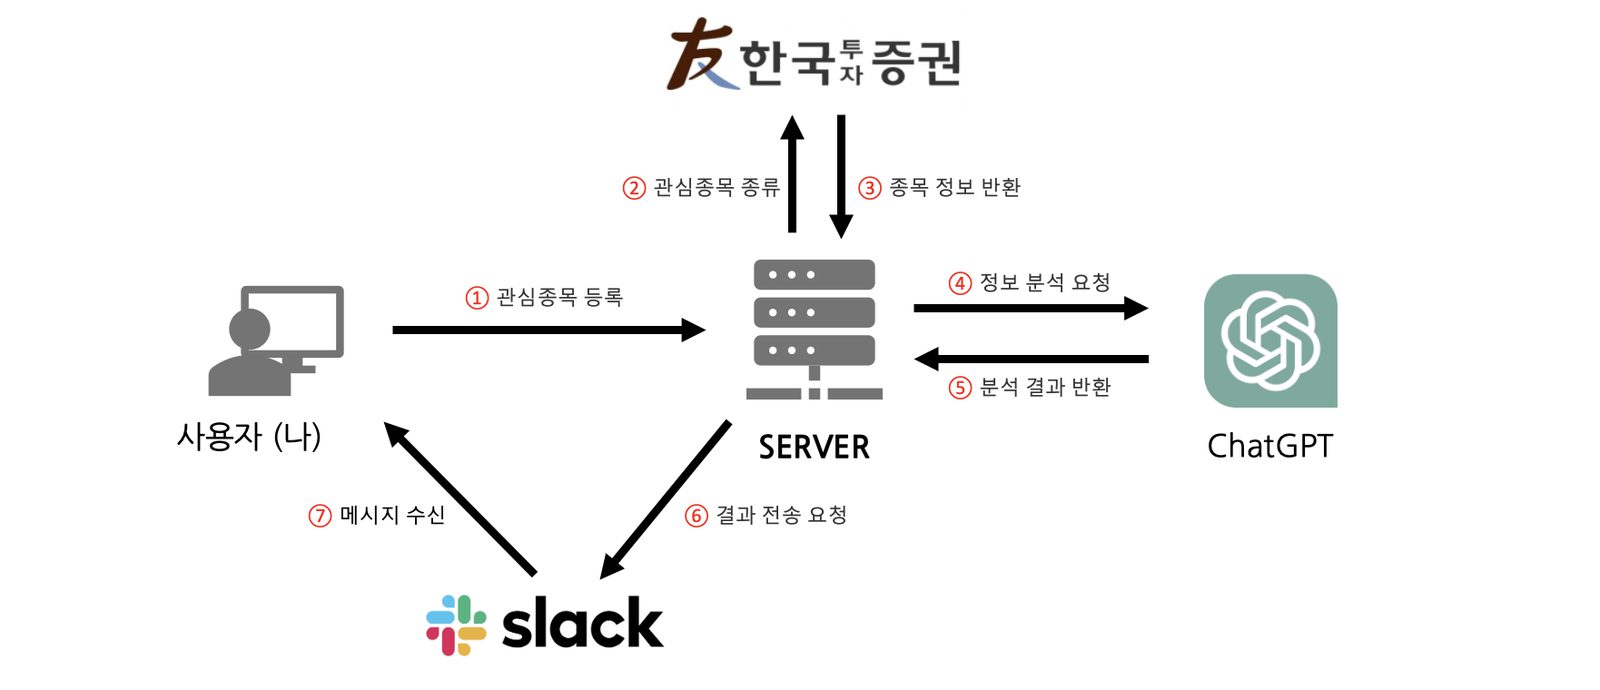
흐름은 단순합니다. 사용자가 관심 종목을 등록하면 서버가 한국투자증권 API에서 시세와 재무 정보를 가져오고, 그 데이터를 정리해 ChatGPT API에 넘기고, 돌아온 분석을 Slack 메시지로 보냅니다. 사용자가 저 혼자였으므로 Slack이 가장 편한 출력 채널이었습니다. 프론트엔드는 React와 TypeScript, Vite로, 서버는 NestJS로 만들었습니다.
데이터 수집: KIS Developers Open API
한국투자증권 Open API는 국내 주식의 기본 시세, 종목 정보, 재무비율, 실시간 체결, 순위 분석, 주문과 계좌 조회까지 REST로 제공하고 해외 주식도 비슷한 범위를 덮습니다. 개인이 쓸 수 있는 증권사 API 중에서는 문서와 모의투자 테스트베드가 잘 갖춰진 편입니다.
다루면서 신경 쓴 부분은 세 가지였습니다.
- 인증 토큰. 앱 키와 시크릿으로 접근 토큰을 발급받아 쓰는 구조라, 토큰을 캐시하고 만료 전에 갱신하는 모듈을 먼저 두었습니다. 요청마다 발급하면 금방 한도에 걸립니다.
- 호출 한도. 초당 호출 수 제한이 있어서 관심 종목을 순회할 때 호출 사이에 간격을 두고, 실패한 호출은 짧은 지수 백오프로 재시도했습니다.
- 실시간 시세. 폴링과 웹소켓 중 무엇을 쓸지는 토스증권의 SLASH 22 발표 "토스증권 실시간 시세 적용기"를 참고했습니다. 시세 수집기에서 Kafka와 Redis를 거쳐 앱으로 가는 구조를 혼자 쓰는 서비스에 그대로 가져올 수는 없지만, "시세는 당겨오는 것이 아니라 밀어내는 것"이라는 원칙은 가져왔습니다.
데이터 정규화: 모델에 무엇을 넘길 것인가
여기가 생각보다 중요했습니다. API 응답을 그대로 프롬프트에 넣으면 필드 이름이 축약 코드라 모델이 해석을 틀리고, 토큰도 낭비됩니다. 그래서 API 응답을 사람이 읽는 이름과 단위를 가진 객체로 한 번 바꾼 뒤에 넘겼습니다. 아래는 단순화한 형태입니다.
type StockSnapshot = {
  name: string;          // 종목명
  code: string;          // 종목코드
  asOf: string;          // 기준일
  price: number;         // 현재가 (원)
  revenue: number;       // 매출액 (억원)
  netIncome: number;     // 순이익 (억원)
  totalAssets: number;   // 자산총액 (억원)
  equity: number;        // 자기자본 (억원)
  roe: number;           // %
  debtRatio: number;     // 부채비율 %
  currentRatio: number;  // 유동비율 %
  revenueGrowth: number; // 매출 성장률 (배)
};
단위를 필드에 고정해 두면 모델이 "억원"과 "원"을 섞어 쓰는 실수가 거의 사라집니다. 반대로 단위가 없는 숫자를 넘기면 그럴듯한 문장 속에 틀린 단위가 섞여 나옵니다. 이 데이터 계층이 결국 리포트 품질의 상한을 정했습니다.
프롬프트 구조
목표는 "정해진 형식의 리포트를 매번 같은 모양으로 받는 것"이었습니다. 자동으로 Slack에 보내려면 형식이 흔들리면 안 됩니다. 프롬프트는 세 층으로 나눴습니다.
- 역할과 규칙(system). 애널리스트 역할, 제공된 데이터만 근거로 쓸 것, 데이터에 없는 사실을 지어내지 말 것, 출력 언어와 섹션 순서.
- 데이터(user). 위의 정규화된 객체를 JSON으로.
- 과제(user). 리포트 종류별 지시문.
실제로 썼던 지시문은 이런 것들입니다.
- 제시된 데이터를 기반으로 상세한 재무 분석과 투자 권장 사항을 제공하라.
- 목표 주가를 제시하고 "매수", "매도" 적합성을 판단하여라.
- 제시된 데이터를 기반으로 종합 재무 보고서를 작성하라.
- CAPM 이론을 활용하여 제시된 관심 종목에 대한 포트폴리오 가중치를 계산하여라.
형식을 잡는 데 가장 효과가 컸던 것은 기법 이름이 붙은 것들이 아니라, 섹션 제목을 고정하고 예시 리포트를 하나 붙이는 것이었습니다. Chain-of-Thought나 Self-Consistency 같은 기법도 살펴봤지만, 이 과제는 추론의 깊이보다 출력의 일관성이 문제였습니다. 온도는 낮게 잡았습니다. 같은 데이터에 같은 리포트가 나와야 하는 작업에서 다양성은 장점이 아닙니다.
출력 검증
모델 출력은 바로 Slack으로 가지 않고 한 번 검사합니다. 검사 항목은 단순합니다.
- 요구한 섹션 제목이 모두 있는가.
- 목표 주가 같은 숫자 필드가 숫자로 파싱되는가.
- 리포트에 등장하는 숫자가 입력 데이터에 있는 값인가.
마지막 항목이 핵심입니다. 입력에 없는 숫자가 나오면 그 리포트는 폐기하고 다시 요청합니다. 환각을 완전히 막지는 못하지만, 적어도 "데이터에 없는 매출액"이 Slack에 올라가는 일은 막습니다. 검증에 실패한 비율이 눈에 띄게 줄어든 시점이 프롬프트가 안정됐다고 판단한 시점이었습니다.
프롬프트 엔지니어링과 파인튜닝 사이
프롬프트만으로 형식이 흔들릴 때의 다음 선택지는 파인튜닝입니다. 사전학습된 모델에 소량의 예시로 출력 스타일을 입히는 방식이고 OpenAI가 API로 제공합니다. 기준은 이렇게 세웠습니다.
- 모델이 무엇을 알아야 하는지가 문제면 검색으로 외부 지식을 붙이는 RAG.
- 모델이 어떻게 행동해야 하는지가 문제면 파인튜닝.
- 둘 다 아니고 형식이 문제면 프롬프트와 검증.
이 프로젝트의 문제는 형식이었고, 프롬프트와 검증 단계에서 충분히 잡혀서 파인튜닝까지 가지 않았습니다. 데이터는 이미 API에서 오므로 RAG도 필요 없었습니다. 둘 다 안 쓴 것이 결론이었고, 그 판단을 내리기 위해 둘 다 알아본 것이 수확이었습니다.
결과물
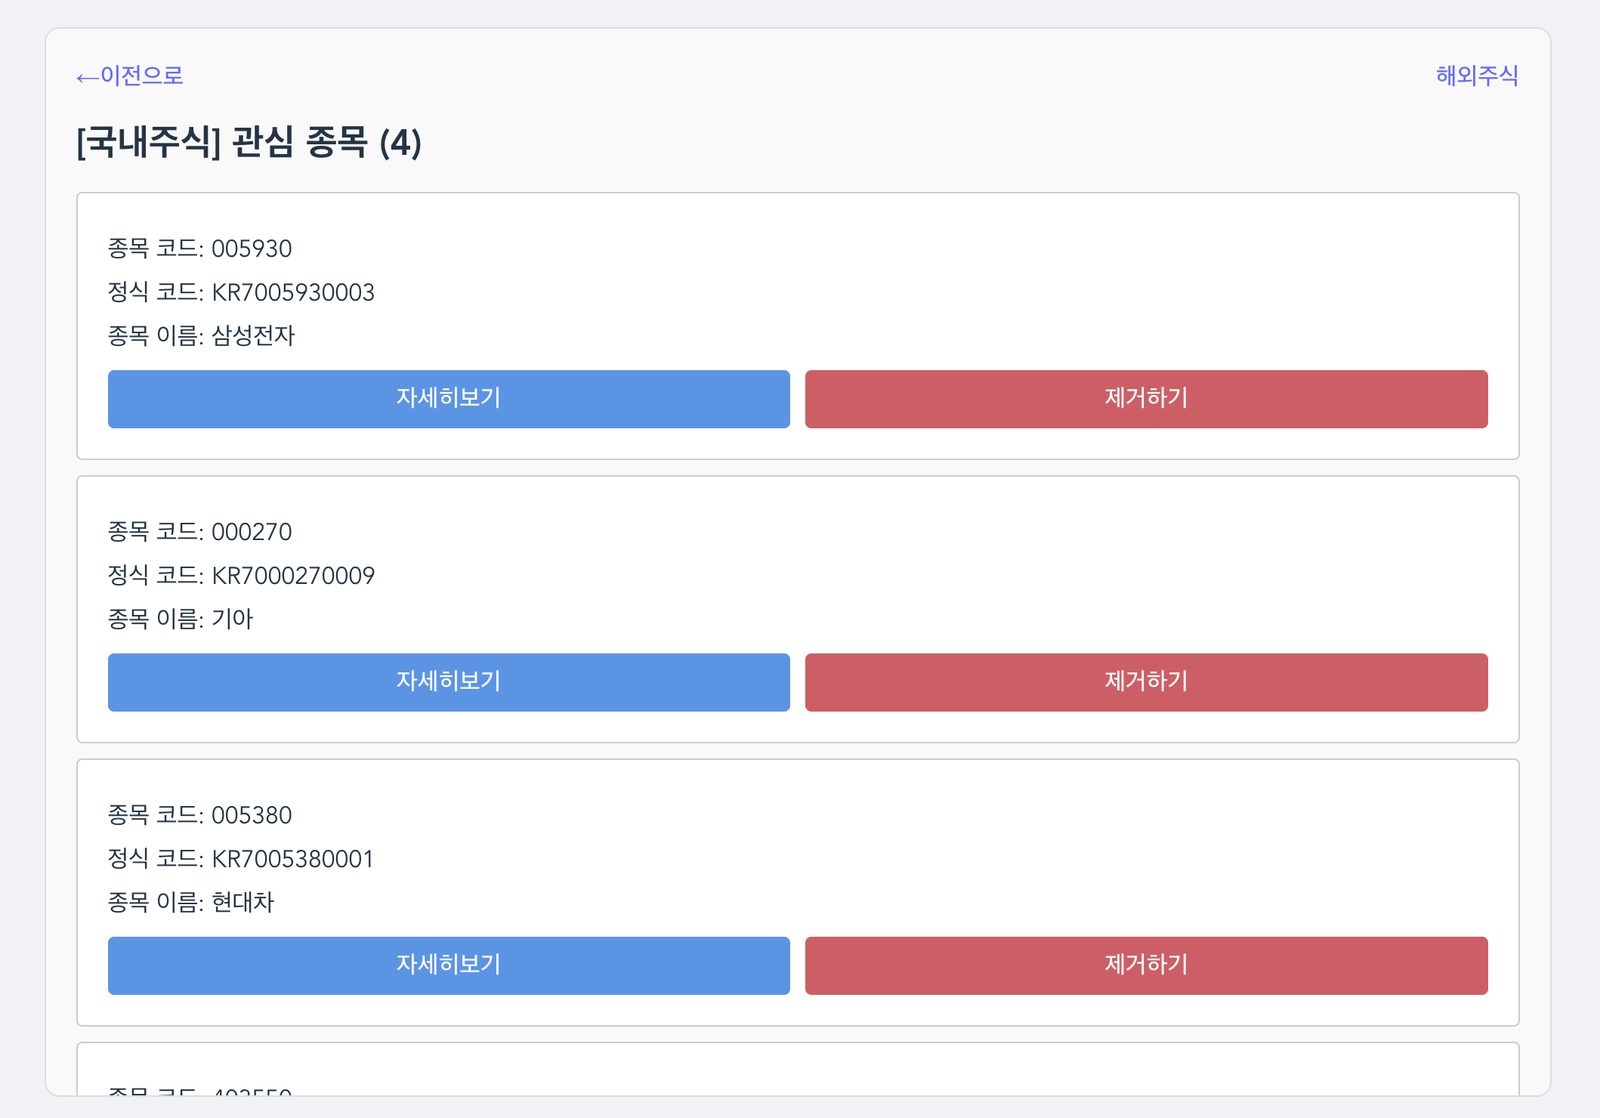
투자 성향을 고르고, 종목 코드로 검색해 관심 종목에 추가하면 됩니다.
알림은 이렇게 옵니다.
리포트는 이렇게 옵니다.
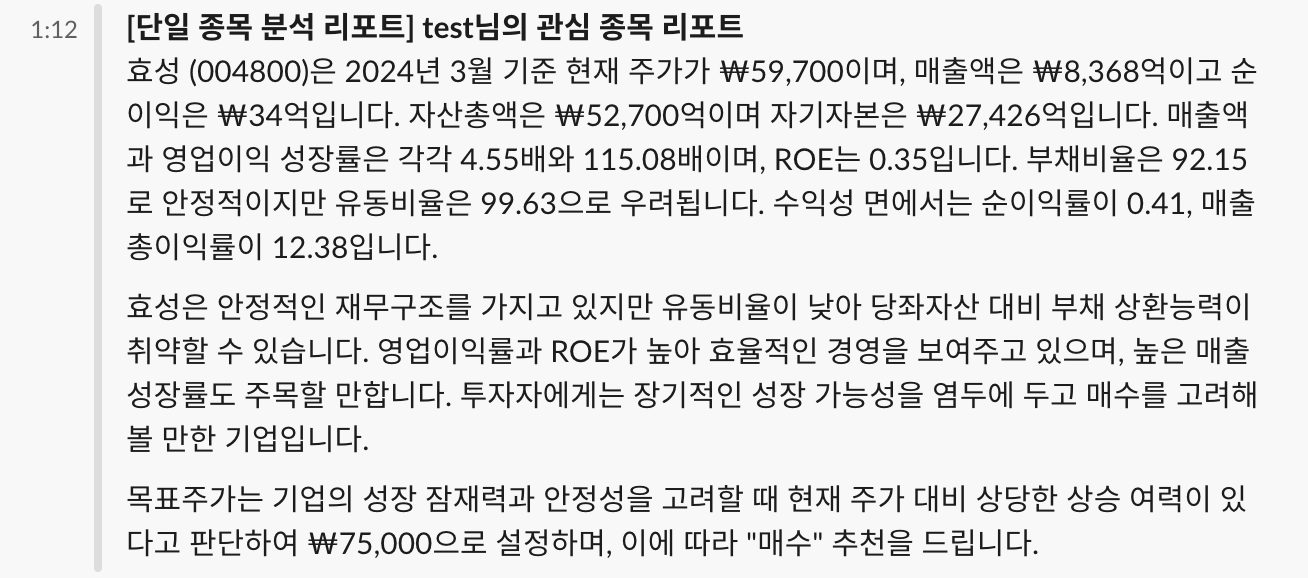
재무 지표를 요약하고, 의미를 풀고, 목표 주가와 판단을 내놓는 데까지 형식이 유지됩니다. 포트폴리오 리포트는 CAPM으로 기대수익률을 구하고 평균-분산 최적화로 비중을 계산해 설명합니다.
비용과 운영
호출 한 번에 넘기는 토큰은 정규화된 데이터 덕분에 작게 유지됐고, 리포트는 종목당 하루 한 번만 생성하도록 캐시했습니다. 같은 입력에 대한 재요청은 검증 실패 시에만 허용했습니다. 시세 알림은 모델을 거치지 않습니다. 숫자를 그대로 보내면 되는 일에 LLM을 쓰는 것은 비용과 지연만 더합니다. 어디에 모델을 쓰고 어디에 안 쓸지를 나눈 것이 운영 비용을 결정했습니다.
다시 만든다면
- 구조화 출력. 자유 텍스트를 받아 검사하는 대신 JSON 스키마를 지정해 받고, 렌더링은 서버가 합니다. 당시에도 가능했지만 그때는 텍스트 리포트가 목표라 쓰지 않았습니다. 지금이라면 스키마를 먼저 정합니다.
- 계산은 코드가, 설명은 모델이. CAPM과 평균-분산 최적화를 모델에게 시킨 것은 지금 보면 잘못된 분업입니다. 수치 계산은 코드로 하고, 모델에는 계산 결과의 해석만 맡겨야 합니다. 모델이 계산하면 맞는지 확인할 방법이 없습니다.
- 평가 세트. 종목 몇 개에 대해 "좋은 리포트"를 손으로 정해 두고 프롬프트를 바꿀 때마다 비교했어야 했습니다. 당시에는 눈으로 봤고, 눈은 생각보다 금방 익숙해집니다.
- 면책을 형식에. "이 리포트는 투자 조언이 아니다"를 프롬프트가 아니라 출력 템플릿에 고정했어야 했습니다.
결론
만들어 보니 두 가지가 분명해졌습니다. 데이터를 정리해 넘기고 형식을 고정하고 검증을 붙이면 "리포트처럼 보이는 것"은 안정적으로 나옵니다. 그 리포트가 맞는지는 전혀 다른 문제이고, 그 차이를 메우는 것이 데이터의 깊이와 검증 체계입니다. 발표 즈음 증권사들도 비슷한 서비스를 내놓고 있었습니다. 유진투자증권의 ChatGPT 기반 AI 애널리스트, 미래에셋의 종목 읽어주는 AI 같은 것들입니다. 방향은 같았고 차이는 그 두 가지였습니다.
코드는 analyst-fe와 analyst-nest에 있고, 서비스는 이후 Wisemind라는 이름으로 이어졌습니다. 자세한 내용은 프로젝트 페이지에 있습니다.